
Open-Source LLMs der CCP
 Niklas Tidbury5 min
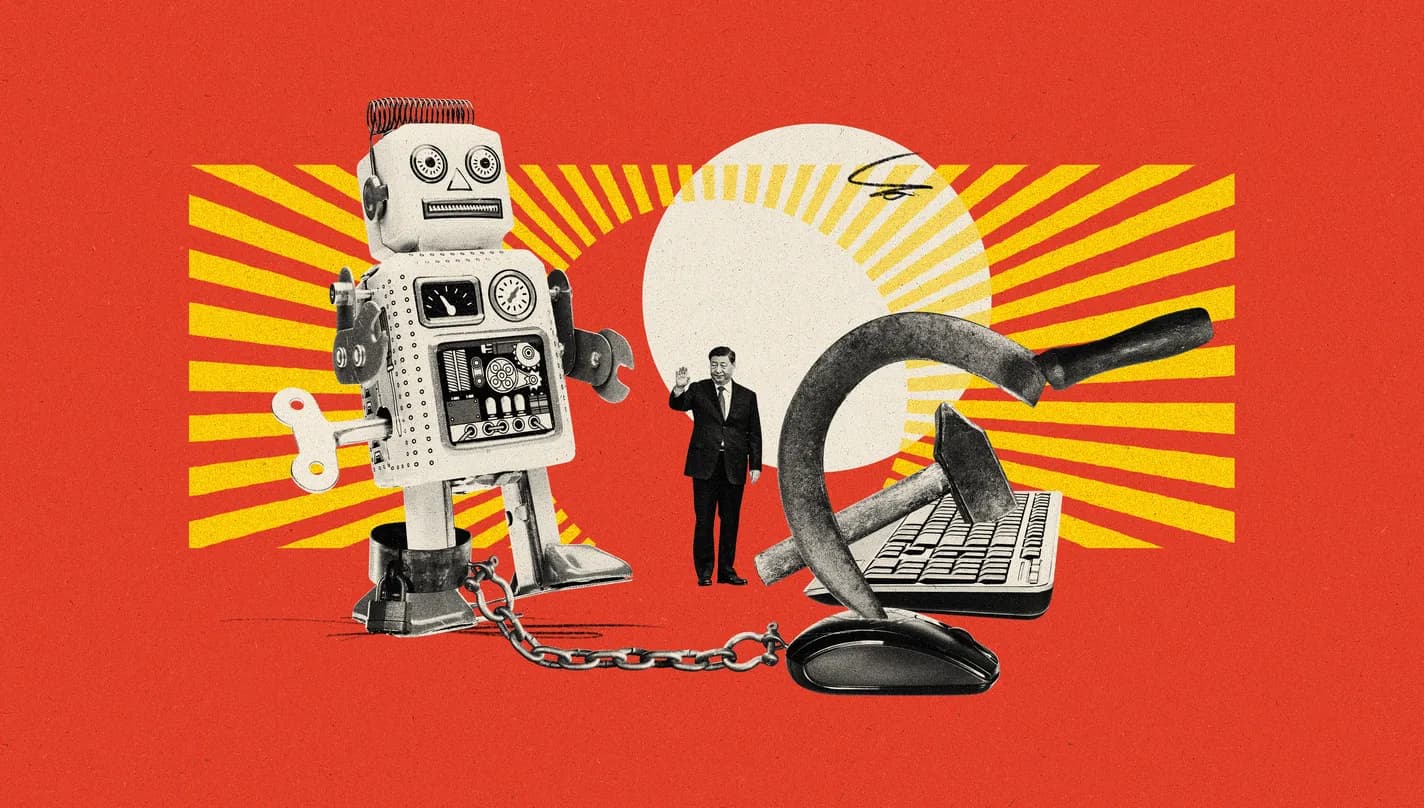
Lokal betrieben sind chinesische Modelle technisch stark und datensouverän. Das geopolitische Risiko ist real, aber deutlich nuancierter als die Schlagzeilen vermuten lassen. Solange Europa hinterher hinkt, ist Pragmatismus keine schlechte Haltung.
Ja, der Titel ist irreführend. Die CCP (Kommunistische Partei Chinas) hat keine Open-Source-LLMs: zumindest nicht offiziell. Aus dem Fernen Osten kommen aber mittlerweile ziemlich viele Modelle: Kimi, Deepseek, GLM, Qwen - und das ist noch lange nicht alles. Chinesische KI-Modelle (insbesondere Open-Weight-LLMs) haben zu globalen Konkurrenten aufgeschlossen und sind in manchen Bereichen sogar an ihnen vorbeigezogen1. Die Frage, die sich dabei stellt: Ist der Einsatz dieser Modelle im Westen überhaupt vertretbar?
Technische Ebene
Fangen wir mit dem an, was die Leute am meisten beschäftigt: «Schicken die meine Daten nach China?»
Kurze Antwort: Nein. Wenn du das Modell lokal betreibst. Lokal heisst hier wirklich lokal. Kein Netzwerkverkehr und kein Telemetrie-Endpoint. Wer hingegen die gehosteten Varianten direkt beim Hersteller nutzt, muss natürlich damit rechnen, dass die Daten irgendwo in chinesischer Rechenzentrum-Infrastruktur landen.
Aber das ist kein China-spezifisches Problem. Der US CLOUD Act erlaubt es US-Strafverfolgungsbehörden, Unternehmen zur Herausgabe gespeicherter Daten zu zwingen - unabhängig davon, wo diese physisch gespeichert sind2. Microsoft, Google, OpenAI: alle gleichermassen betroffen3. 2025 hat Microsoft sogar öffentlich eingeräumt, dass man für EU-Kunden keine Datensouveränität garantieren kann4. Willkommen in der schönen neuen Datenwelt.
Was die Modelle selbst angeht: Alibabas Qwen-Modellfamilie hat Metas Llama im September 2025 als meistgeladene Sprachmodellfamilie auf Hugging Face abgelöst. Zwischen August 2024 und August 2025 stammten 17,1 Prozent aller Downloads von chinesischen Entwicklern, gegenüber 15,8 Prozent aus den USA5. Dass «Open Source» hier automatisch «transparente Pipeline» bedeutet, wäre trotzdem ein Trugschluss. Das Training ist nicht offen dokumentiert, und das bringt regulatorisch orientierte Menschen verständlicherweise ins Schwitzen. Wer auf EU-AI-Act-Konformität angewiesen ist, hat hier seine Hausaufgaben zu machen.
Politische Ebene
Jetzt wirds komplizierter. Chinesische Modelle zensieren bestimmte Themen wie Taiwan, Menschenrechte und Tiananmen. Das ist keine Verschwörungstheorie, das lässt sich reproduzieren. Für viele Anwendungsfälle spielt das keine Rolle.
Dazu kommt die Frage der Supply-Chain-Abhängigkeit: Was passiert, wenn ein Anbieter den Stecker zieht? Das ist übrigens kein hypothetisches Szenario: ende 2024 machten chinesische Modelle einen Prozent der globalen KI-Workloads aus. Ende 2025 waren es bereits 30 Prozent6. Eine Abhängigkeit in dieser Grössenordnung ist keine Kleinigkeit.
Das Chinesische National Intelligence Law von 2017 klingt bedrohlich. Es verpflichtet chinesische Unternehmen und Bürger dazu, «nationale Geheimdienstbemühungen zu unterstützen, daran mitzuwirken und zu kooperieren» - eine Formulierung, die Beijing offenbar berechtigt, seine Unternehmen zur nachrichtendienstlichen Kooperation zu zwingen7. Für lokale Deployments ohne Datenübertragung ist das aber schlicht irrelevant, da man ja keine Daten sendet. Rechtswissenschaftler haben ausserdem darauf hingewiesen, dass Artikel 7 des Gesetzes keinen Durchsetzungsmechanismus enthält und Sanktionen nur dann möglich sind, wenn Geheimdienstarbeit aktiv «behindert» wird.
Was häufig kolportiert wird: Chinesische Modelle seien um ein Vielfaches leichter jailbreakbar als vergleichbare US-Modelle. Das ist nicht ganz falsch. Tests des US-Regierungszentrums CAISI ergaben, dass Deepseek-Modelle im Schnitt zwölfmal anfälliger für Jailbreaking-Angriffe sind als vergleichbare amerikanische Modelle8. Cisco hat diese Befunde unabhängig bestätigt und berichtete von einer 100-prozentigen Angriffsquote gegen DeepSeek R1 - das Modell hat keinen einzigen schädlichen Prompt blockiert. Die Relevanz ist auch wieder nur im Anwendungsfall ersichtlich.
Und die grossen Horrorszenarien: technische Backdoors in den Weights? Stanford HAI hält chinesische Open-Weight-Modelle im globalen KI-Wettbewerb für schlicht unvermeidlich und betont, dass das eigentliche Risiko nicht im Code selbst liegt, sondern in der juristischen und geopolitischen Abhängigkeit vom Entwicklerland9. Das ist real, aber deutlich nuancierter als «das Modell spioniert dich aus».
Und jetzt?
Was soll man priorisieren: Technik oder Politik?
Ehrliche Antwort: Beides, aber mit gesundem Augenmass. Dass DeepSeek von einer chinesischen Organisation veröffentlicht wurde, unterstreicht die Notwendigkeit, strategisch über regulatorische Massnahmen und geopolitische Implikationen nachzudenken - in einem globalen KI-Ökosystem, in dem nicht alle Akteure dieselben Normen teilen. Aber Europa bietet noch nichts annähernd Vergleichbares, und wer wettbewerbsfähig bleiben will, kann es sich nicht leisten, aus rein geopolitischen Reflexen auf leistungsstarke Werkzeuge zu verzichten.
Mistral ist gut. Wirklich. Mistral Small läuft auf 16 GB VRAM, ist DSGVO-konform und hält auf vielen Benchmarks mit. Für klar umrissene, lokale Anwendungsfälle ist das eine vollkommen legitime Wahl. Aber Mistral ist eine einzelne Firma, China hat Dutzende. Baidu allein veröffentlichte 2025 über 100 Modelle auf Hugging Face, nachdem es 2024 noch gar keine publiziert hatte10. ByteDance und Tencent steigerten ihre Modell-Outputrate um bis zu 900 Prozent. Europa hat schlicht keine vergleichbare Kadenz, kein vergleichbares Ökosystem, und kein vergleichbares Investitionsvolumen. Private KI-Investitionen lagen in Europa 2025 bei rund 8 Milliarden Dollar, gegenüber 109 Milliarden in den USA11. Frontier-Modelltraining kostet heute Hunderte Millionen pro Run. Die Rechnung geht nicht auf.
Das bedeutet nicht, dass Europa irrelevant ist — die regulatorische Nische ist echt und wertvoll. Aber wer wettbewerbsfähig bleiben will, kann es sich nicht leisten, aus rein geopolitischen Reflexen auf leistungsstarke Werkzeuge zu verzichten.
Bewusster Pragmatismus schlägt regulatorische Angst, solange man weiss, was man tut. Die Daten bleiben beim Kunden. Das ist das Entscheidende. Wer das sicherstellt, kann diese Modelle mit ruhigem Gewissen einsetzen.
Headerbild: Klawe Rzeczy
Fussnoten
- Stanford HAI – Beyond DeepSeek ↩︎
- Wikipedia – US CLOUD Act ↩︎
- Claromentis – CLOUD Act Implications ↩︎
- Microsoft Guarantees ↩︎
- Stanford HAI via The Decoder ↩︎
- War on the Rocks – China's AI Is Spreading Fast ↩︎
- China Law Translate – National Intelligence Law ↩︎
- CAISI Evaluation ↩︎
- Stanford HAI – DeepSeek Discussion ↩︎
- The New Stack – Chinese Leadership ↩︎
- Index.dev – EU/China/USA ↩︎